Un código QR puede estar perfectamente bien construido y, aun así, llevar a un lugar que no esperabas. La cámara no intenta averiguar quién pegó ese cuadrado en una mesa, quién lo incluyó en un correo ni si la página de destino pertenece realmente a la organización que aparece alrededor. Su primera tarea es mucho más limitada: reconocer el patrón y recuperar los datos que contiene.
Esa separación importa porque solemos percibir el escaneo como una sola acción. Enfocamos el código, aparece una sugerencia en la pantalla y tocamos casi de inmediato. En realidad, entre la lectura y la apertura todavía queda una decisión. El teléfono puede haber leído correctamente el QR y la persona todavía tiene la opción de no continuar.
Ahí está la utilidad práctica de entender esta tecnología. No hace falta memorizar cómo se distribuyen todos sus módulos ni aprender a generar códigos. Basta con distinguir qué comprueba realmente el lector, qué información obtiene y qué aspectos siguen dependiendo del contexto.
La diferencia se vuelve especialmente visible cuando el QR contiene una dirección web. El patrón puede ser válido, la lectura resultar exacta y la URL funcionar sin problemas; nada de eso demuestra, por sí solo, que el destino sea el que esperabas.
La cámara puede leer el código, pero no autenticar quién lo puso ahí
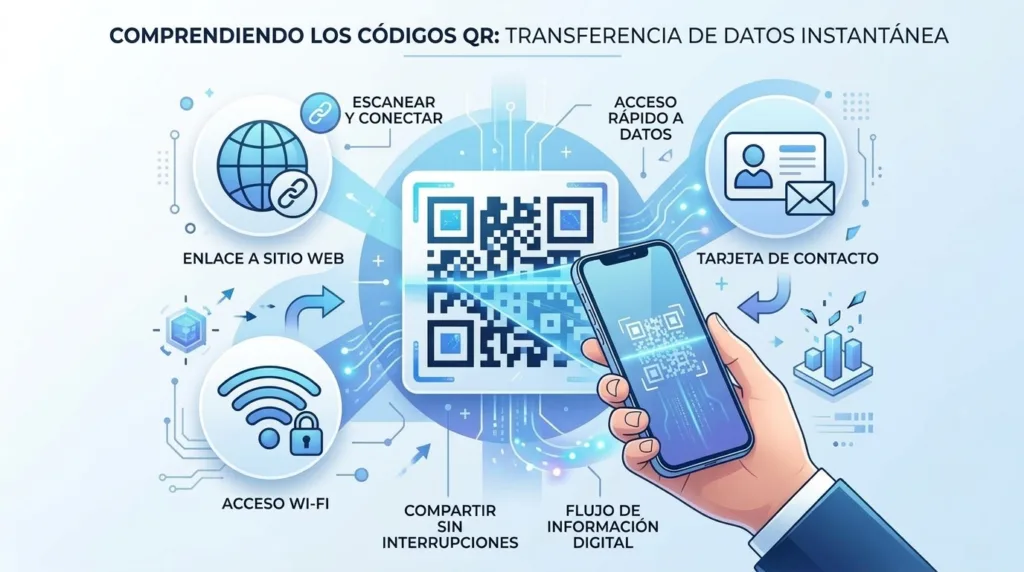
Un QR es un código bidimensional. UNAM Mobile explica que, a diferencia de un código de barras convencional, distribuye información tanto a lo ancho como a lo alto y admite distintos tipos de datos, entre ellos texto y direcciones web. Para el usuario, el resultado se parece a una imagen; para el lector, es una estructura diseñada para reconstruir información.
Los elementos grandes situados en tres esquinas ayudan a localizar el símbolo y reconocer su orientación. DENSO WAVE, la empresa que desarrolló el formato, documenta que un QR se puede leer desde distintas direcciones y que incorpora mecanismos de corrección de errores. Gracias a ello, una pequeña mancha o un daño parcial no siempre impiden recuperar el contenido, aunque la tolerancia tiene límites y depende de cuánto se haya perdido.
El proceso ocurre antes de que Internet entre necesariamente en escena. Si el código contiene un texto, el dispositivo lo reconstruye de forma local. Cuando contiene una URL, en cambio, la conexión será necesaria al intentar visitar el sitio. La lectura del patrón y el acceso al recurso son momentos distintos.
La interfaz del teléfono deja una pista de esa separación. La documentación de Apple México indica que, después de colocar el QR dentro del campo de la cámara, aparece un enlace que el usuario puede tocar para abrir el contenido. Ese toque adicional parece mínimo, pero conserva una posibilidad de revisión entre lo que la cámara encontró y lo que el navegador hará después.
No todos los códigos guardan una URL. Algunos contienen texto, datos utilizados por una aplicación o información que otro sistema sabe interpretar. Incluso cuando el resultado sí es una dirección web, el QR no contiene la página completa: contiene los datos necesarios para señalarla. A partir de ahí intervienen el navegador, la conexión, el DNS y el servidor que finalmente responde.
Esto explica también por qué una captura de pantalla puede seguir siendo legible. Mientras el patrón conserve suficiente definición, contraste y espacio alrededor, el lector trabaja con la representación visual del código. No necesita el archivo con el que se generó originalmente.
La consecuencia menos evidente aparece cuando una URL lleva primero a un servicio intermediario. El código puede guardar una dirección que responde con una redirección y envía al navegador hacia otro sitio. El dibujo impreso permanece igual, aunque el destino final cambie en el servidor. Es una solución legítima para campañas, menús o materiales que necesitan actualizarse sin volver a imprimir el QR, pero añade una etapa que normalmente permanece fuera de la vista.
Aquí resulta útil reconocer las partes básicas de una dirección. En qué es una URL y qué significa cada parte de una dirección web vimos que el dominio, la ruta, los parámetros y otros componentes no cumplen la misma función. Al escanear un QR, esa lectura permite distinguir el sitio al que apunta de palabras llamativas que puedan aparecer en otras zonas de la dirección.
Hasta este punto, la cámara puede haber hecho todo correctamente. Ha encontrado el símbolo, reconstruido sus datos y mostrado una acción compatible. Lo que no ha determinado es si ese código fue colocado por quien tú crees, si la dirección es apropiada para el contexto o si tiene sentido entregar información en la página que aparecerá después.
La decisión útil empieza cuando aparece el resultado del escaneo
Un QR colocado en el menú de un restaurante hereda parte de la confianza que tenemos en la mesa, el local y el material impreso. Lo mismo ocurre con un código situado en un cartel universitario, una máquina de estacionamiento o una hoja que parece institucional. Ese contexto favorece una reacción rápida; alguien también puede aprovecharlo sustituyendo el código original por otro.
El Departamento de Seguridad Informática del Instituto Politécnico Nacional advierte precisamente sobre esa posibilidad. En su material sobre riesgos asociados con QR menciona el quishing —phishing mediante códigos QR— y recomienda observar si, en espacios públicos, existe una calcomanía colocada encima de otra. El punto práctico es muy concreto: un lector comprueba la estructura del QR, pero no sabe quién pegó físicamente esa etiqueta.
La vista previa del enlace cobra importancia justo ahí. Cuando un código supuestamente pertenece a una universidad, un banco o una empresa conocida, el dominio debería guardar alguna relación razonable con ese contexto. No hace falta estudiar una dirección enorme carácter por carácter; interesa reconocer qué sitio está intentando abrir el teléfono.
Una palabra conocida llega a aparecer dentro de una ruta o de un subdominio extraño y producir una impresión engañosa. Tampoco encontrar https basta para decidir que una página es legítima. HTTPS protege la comunicación con el servidor al que llegaste; no certifica que ese servidor represente a la institución que esperabas. Los criterios desarrollados en cómo saber si un sitio web es confiable antes de usarlo siguen siendo necesarios aunque el recorrido haya empezado con la cámara.
Hay casos en los que la primera dirección no permite una conclusión inmediata. Un servicio legítimo utiliza a veces enlaces cortos, redirecciones o dominios distintos para ciertas funciones. En vez de convertir cualquier diferencia en una alarma automática, vale más observar qué ocurre después. Una solicitud inesperada de credenciales, un aviso de urgencia, una descarga que no estaba prevista o una petición de instalar algo cambian bastante el nivel de cautela necesario.
El IPN señala, por ejemplo, que los QR se utilizan como vehículo de phishing y que los mensajes urgentes merecen especial atención. Ese mecanismo se parece al que ya vimos en phishing explicado con ejemplos: quien intenta engañar busca reducir el tiempo que la persona dedica a comprobar el contexto antes de actuar.
Un pago requiere una pausa distinta. Escanear puede abrir una página o una aplicación legítima, pero la confirmación posterior sigue siendo otra decisión. Revisar el destinatario, el comercio y el monto evita tratar el código como si él mismo garantizara la operación.
Con un inicio de sesión ocurre algo parecido. Si el QR llegó en un correo inesperado y después abre una pantalla que solicita usuario y contraseña, la pregunta relevante deja de ser si la cámara leyó bien el símbolo. La atención pasa al servicio que está pidiendo las credenciales y a la razón por la que llegaste hasta allí.
Ese matiz evita caer en el extremo contrario. Escanear un QR no vuelve automáticamente peligroso al teléfono, del mismo modo que abrir la cámara no concede por sí solo acceso a tus cuentas. El riesgo depende del contenido interpretado, de la aplicación implicada y, con mucha frecuencia, de lo que la persona haga después: visitar una página, iniciar sesión, aprobar un pago, instalar software o conceder un permiso.
También cambia la manera de reaccionar ante un código dudoso. Cuando la vista previa no coincide con lo esperado, no hace falta experimentar para descubrir qué hay detrás. Puedes cerrar la sugerencia y acceder al servicio por una ruta conocida: abrir su aplicación oficial, escribir una dirección guardada o buscar el portal desde un canal que ya utilizabas.
Un código falso y uno legítimo pueden resultar igual de fáciles de escanear. Esa es precisamente la limitación que conviene recordar. La cámara responde con bastante precisión a la pregunta “¿qué datos hay aquí?”; la pregunta “¿debo hacer lo que esos datos proponen?” sigue abierta unos segundos más.
En una mesa, un cartel o un correo, esos segundos bastan para mirar el dominio, comprobar que la acción tiene sentido y detenerse cuando algo no encaja. Si el código conduce exactamente al servicio esperado, el proceso continúa. Si no, todavía estás a tiempo de cerrar la vista previa sin convertir una lectura correcta en una decisión equivocada.
Martin Rojas es especialista en tecnología y trabaja con herramientas digitales, computadoras, Internet y software desde hace muchos años. A lo largo de su trayectoria ha realizado cursos de actualización y desarrollado experiencia práctica con diferentes plataformas, sistemas y soluciones digitales. En Skydutz, transforma ese conocimiento técnico en explicaciones claras para estudiantes, profesionales y personas que quieren entender mejor la tecnología que utilizan todos los días.