Cuando haces clic en “Reservar lugar” y, un segundo después, aparece la confirmación en pantalla, la experiencia parece ocurrir en un solo sitio: el navegador. Sin embargo, esa acción quizá haya recorrido varias capas antes de regresar convertida en un mensaje visible. Parte del trabajo sucede frente a ti; otra parte ocurre en servidores que nunca ves.
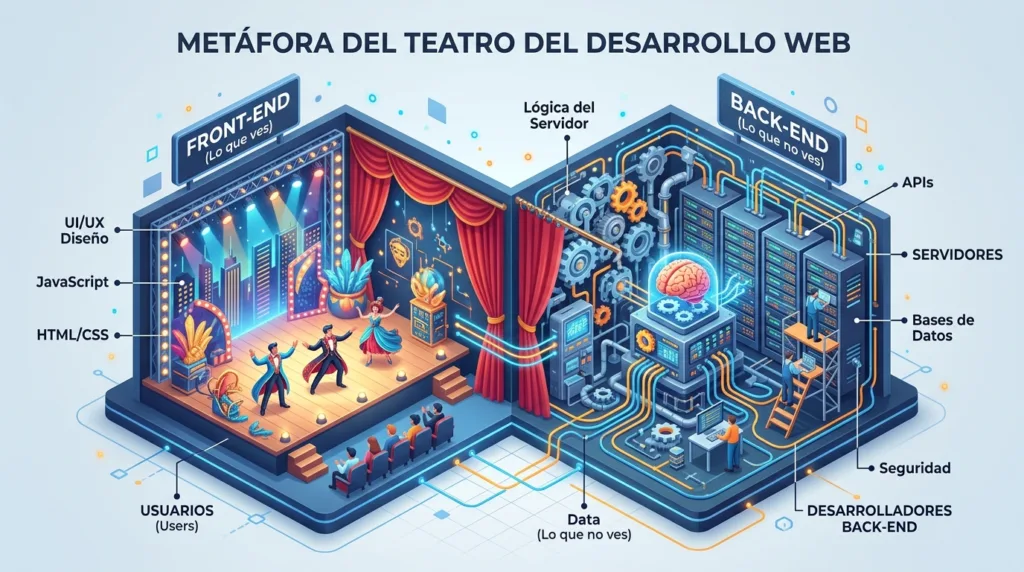
Esa división suele resumirse con dos palabras, front-end y back-end. La explicación rápida —“lo que ves” frente a “lo que está detrás”— ayuda al principio, aunque se queda corta muy pronto. Una página moderna muestra información generada por un servidor, ejecuta lógica dentro del navegador y consulta datos remotos sin cambiar de pantalla. Para entender la diferencia conviene seguir una acción real y observar quién se encarga de cada parte.
El navegador termina su trabajo justo donde empieza otra parte del sistema
El front-end vive, en gran medida, en el lado con el que interactúa la persona. Ahí aparecen botones, formularios, menús, mensajes, gráficos y demás elementos de la interfaz. HTML organiza el contenido; CSS controla buena parte de la presentación; JavaScript permite responder a acciones y modificar la página mientras la utilizas. En el artículo sobre HTML, CSS y JavaScript ya vimos cómo esas tres tecnologías colaboran dentro del navegador.
La Red de Responsables TIC de la UNAM describe al desarrollador front-end como el especialista que trabaja con la interfaz de usuario de los sitios web. En sus materiales de sistemas y aplicaciones, la misma colección distingue esa función del trabajo back-end, relacionado con el procesamiento de peticiones y el uso de bases de datos.
La frontera, de todos modos, no está dibujada en la pantalla. Un botón pertenece claramente a la interfaz; la acción que inicia, en cambio, quizá dependa de un servidor. Un formulario de acceso se construye en el front-end; comprobar si las credenciales corresponden a una cuenta válida requiere normalmente consultar información que no debería quedar expuesta dentro del navegador.
Ahí entra el back-end. Entre sus tareas están recibir solicitudes, aplicar reglas, consultar bases de datos, verificar permisos, guardar cambios y preparar respuestas. Según el proyecto, ese código puede estar escrito en Python, Java, PHP, C#, JavaScript u otros lenguajes. Lo decisivo no es el nombre de la tecnología, sino el lugar que ocupa dentro de la arquitectura y las responsabilidades que asume.
Por eso una aplicación web no se entiende bien si imaginamos dos cajas independientes. El front-end necesita pedir información; el back-end necesita devolverla en una forma que la interfaz pueda utilizar. Entre ambos existe una conversación constante.
Una reserva permite ver esa conversación en movimiento
Supongamos que una universidad publica un formulario para reservar lugar en un taller. Quedan tres espacios disponibles. Escribes tu nombre, eliges un horario y presionas el botón de confirmación.
Lo que ocurre después depende de cómo esté construida la aplicación, pero un flujo habitual permite distinguir varias responsabilidades sin convertirlas en definiciones abstractas.
Primero responde la interfaz
Antes de enviar nada, el front-end suele revisar cuestiones sencillas: que el campo del nombre no esté vacío, que hayas seleccionado un horario o que el correo tenga una estructura razonable. Esa validación inmediata mejora la experiencia porque evita un viaje innecesario al servidor cuando falta información evidente.
No obstante, el navegador no debería tener la última palabra sobre datos importantes. Una persona puede modificar el código que se ejecuta en su propio dispositivo o enviar una solicitud por otros medios. Por eso el back-end necesita volver a comprobar aquello que realmente importa para el sistema.
En nuestro ejemplo, la interfaz muestra “3 lugares disponibles”, pero ese número podría haber cambiado desde que abriste la página. Otra persona quizá reservó unos segundos antes.
Luego la solicitud sale del navegador
Al presionar el botón, el front-end suele enviar una solicitud HTTP al servidor con los datos necesarios para intentar crear la reserva. MDN explica en su descripción general de cliente y servidor que los navegadores utilizan HTTP para solicitar recursos o enviar información, mientras el servidor procesa esas peticiones y devuelve una respuesta.
El back-end recibe la solicitud y ahí comienza un tipo distinto de trabajo. Comprueba si el taller existe, si el horario sigue abierto, si quedan lugares y, dependiendo de las reglas, quizá revise que la misma persona no tenga ya una reserva.
Después consulta una base de datos. Si todavía hay espacio, registra la inscripción y actualiza la cantidad disponible. Si el último lugar ya fue tomado, rechaza la operación. Aunque el front-end hubiera mostrado disponibilidad, el servidor trabaja con el estado más reciente que conoce.
La Red TIC de la UNAM describe el trabajo back-end precisamente alrededor de módulos de procesamiento, contenido dinámico y almacenamiento de información mediante bases de datos. En una aplicación real, además, esta capa se comunica a menudo con otros servicios: correo, almacenamiento, sistemas institucionales o APIs externas.
La respuesta regresa y la pantalla cambia
Una vez procesada la petición, el servidor devuelve una respuesta. No tiene por qué enviar una página completa. En muchas aplicaciones modernas devuelve datos que JavaScript interpreta para modificar solo una parte de la interfaz.
Si la reserva se creó correctamente, el front-end oculta el formulario, muestra el folio y actualiza el número de lugares disponibles. En cambio, si el servidor responde que ya no hay cupo, la interfaz presenta ese mensaje y permite elegir otro horario.
La persona continúa viendo una sola página. Mientras tanto, navegador y servidor ya intercambiaron información.
Esa secuencia enlaza con cómo funciona Internet: la solicitud necesita viajar hasta otro equipo y la respuesta debe regresar. La diferencia es que ahora podemos distinguir qué hace cada programa en los extremos de ese recorrido.
Front-end y back-end se separan por responsabilidad, no por apariencia
Hay tareas que parecen pertenecer claramente a un lado. El color de un botón es una preocupación de la interfaz; guardar una nueva reserva en una base de datos corresponde al servidor. Sin embargo, muchos comportamientos requieren participación de ambos.
| Situación | Front-end | Back-end |
|---|---|---|
| Mostrar horarios disponibles | Presenta las opciones y permite elegir | Obtiene o calcula cuáles siguen disponibles |
| Iniciar sesión | Recoge los datos y muestra el resultado | Verifica la cuenta, permisos y estado de la sesión |
| Publicar un comentario | Captura el texto y actualiza la vista | Valida, guarda y devuelve el comentario registrado |
| Consultar un perfil | Organiza la información en pantalla | Recupera los datos permitidos para ese usuario |
La tabla parece dividir las tareas con limpieza, pero en proyectos reales hay matices. Un front-end llega a realizar cálculos complejos sin consultar al servidor. A su vez, el back-end genera en ciertos proyectos HTML completo y lo envía ya preparado para que el navegador lo muestre. Incluso una misma aplicación combina varias estrategias según la página.
Además, back-end no significa simplemente “base de datos”. La base es una pieza frecuente, aunque el código del servidor también aplica reglas de negocio, se comunica con otros sistemas, controla acceso, transforma información o coordina procesos. Del mismo modo, front-end no equivale únicamente a “diseño”: allí también existe programación, manejo de estados, validaciones, solicitudes de red y lógica de interacción.
Microsoft Learn, en su módulo de introducción al desarrollo web en español de México, utiliza HTML, CSS y JavaScript para construir la parte interactiva de una página. Cuando el proyecto necesita conservar datos o responder de forma distinta según cada usuario, aparecen responsabilidades que ya no caben únicamente dentro de esos archivos locales.
También existe el término full-stack, utilizado para profesionales o perfiles que trabajan en ambos lados. Eso no significa dominar cada tecnología imaginable. Un desarrollador puede abarcar el recorrido completo de una aplicación y, aun así, tener mayor profundidad en ciertas capas.
En realidad, la frontera se mueve con la arquitectura. Lo importante es poder identificar dónde se ejecuta una decisión, quién tiene acceso a determinada información y qué componente es responsable de conservar el estado correcto.
Cuando algo falla, la pantalla solo muestra el último síntoma
Las diferencias entre front-end y back-end se vuelven especialmente claras cuando una aplicación deja de comportarse como esperamos.
El botón puede no responder porque un evento de JavaScript nunca se ejecutó. También puede responder correctamente y enviar la solicitud, pero recibir un error del servidor. En otro caso, el back-end funciona bien, aunque la base de datos tarde demasiado. Incluso puede ocurrir que todo eso esté correcto y la conexión de red se interrumpa antes de que llegue la respuesta.
Para quien usa la página, varios de esos problemas terminan pareciéndose: “no funcionó”.
Para quien desarrolla, en cambio, localizar la capa donde comenzó el fallo cambia por completo la investigación. Las herramientas del navegador permiten observar errores de JavaScript y solicitudes de red; los registros del servidor muestran lo que ocurrió al procesar una petición; la base de datos aporta otra parte de la historia.
MDN explica, al describir qué es un servidor web, que un servidor HTTP recibe solicitudes y debe responder a ellas, incluso cuando el resultado es un error. Un 404 indica una situación distinta de una respuesta exitosa, y una aplicación dinámica añade todavía más estados según su propia lógica.
Esa perspectiva evita pensar en una página como una superficie aislada. Lo que aparece en pantalla es, muchas veces, el resultado visible de una cadena de componentes que colaboraron durante unos milisegundos.
Cuando la reserva del taller termina con un folio en pantalla, el front-end hizo visible el proceso. El back-end decidió si la operación podía realizarse y conservó el cambio. Entre ambos viajaron solicitudes y respuestas que el usuario no necesitó ver.
Comprender esa separación no sirve únicamente para elegir si te interesa estudiar front-end o back-end. También permite leer una aplicación con mayor precisión: qué parte está ocurriendo en tu navegador, qué información tuvo que salir de él y qué decisiones solo pueden resolverse en otro lado.
Martin Rojas es especialista en tecnología y trabaja con herramientas digitales, computadoras, Internet y software desde hace muchos años. A lo largo de su trayectoria ha realizado cursos de actualización y desarrollado experiencia práctica con diferentes plataformas, sistemas y soluciones digitales. En Skydutz, transforma ese conocimiento técnico en explicaciones claras para estudiantes, profesionales y personas que quieren entender mejor la tecnología que utilizan todos los días.